我把几家 AI PPT 产品的文档、创始人访谈、论文和开源项目放在一起看,最先碰到的问题很朴素。
它们都说自己能导出 PPTX。可一个能在 PowerPoint 里打开的文件,可能只装着一张铺满页面的图片,也可能保留着文字、形状、表格和图表。前一种文件适合放映,改一句标题都费劲。后一种文件才接得住日常工作,换数据、调版式、沿用公司模板,都有地方下手。
这个区别贯穿了 AI PPT 这几年的变化。我现在更愿意把它看成一条编译链。系统先决定整套演示要讲什么,再把每一页写成结构化计划,交给布局或编辑工具执行,渲染出来看一眼,发现问题后回去改。大模型负责其中一部分,剩下的工作落在模板、页面表示、字体测量、转换器和反馈系统上。
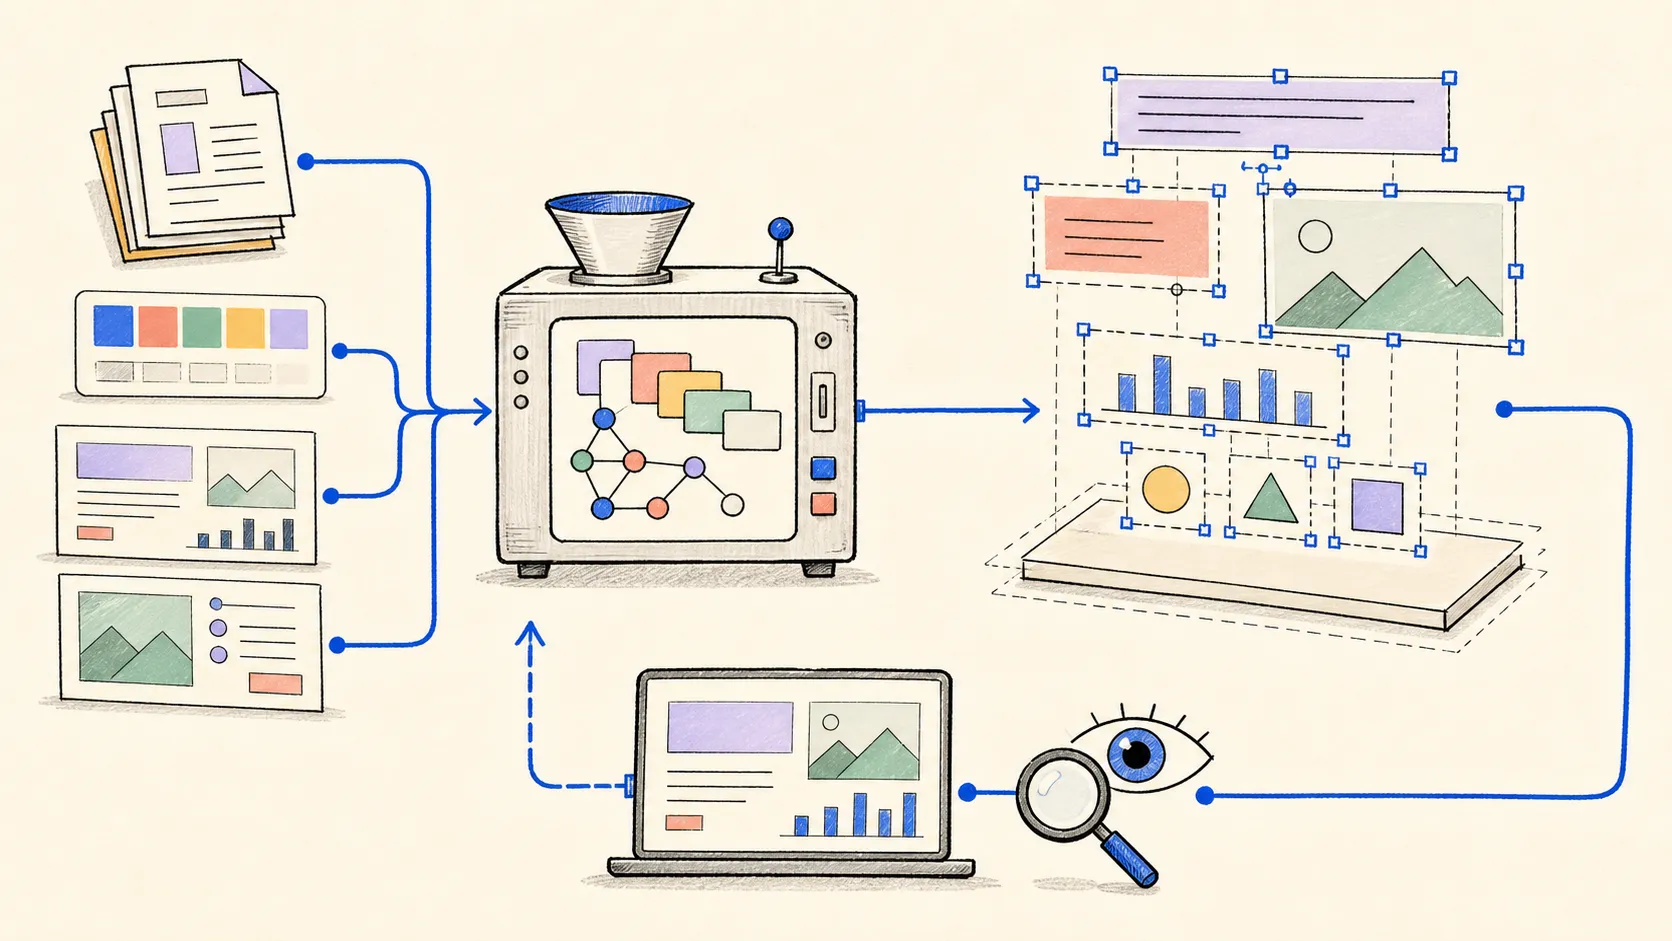
这张概念图把资料、模板、页面对象和渲染反馈接在了一起。
这篇文章里的产品能力以官方文档和创始人访谈为准,具体实现尽量看论文与源码。厂商没有公开的模型和布局算法,我只写成推断。
一份 PPTX 里到底装了什么
幻灯片比普通文档麻烦。内容需要压缩,还得在十几页里形成顺序。页面只有固定大小,文字、图片和图表一多,换行、留白和层级马上互相挤。文件交出去以后,别人通常还要继续改。
这些要求会打架。整页生成一张图,风格容易统一,文字和图表也跟着压平了。直接写 PowerPoint 对象,编辑方便,系统就得处理坐标、字体替换、文本测量和对象关系。文件能打开,只说明序列化成功,离可用还很远。
PPTBench 的结果很能说明这个落差。受测多模态模型理解一页在讲什么,通常比生成布局和执行结构化编辑做得好。模型可以解释页面意图,到了具体操作,仍会出现错位、重叠和 API 调用不稳定。
讨论这类系统时,模板、HTML、图片和 Agent 经常被排成几条互相竞争的路线。放到实现里,它们处在不同位置。模板给出设计约束,HTML、SVG、Scene Graph 和 PowerPoint 对象图保存页面结构,图片承载素材或最终像素,Agent 负责规划和调用工具。把它们混在一起,很多产品差异就说不清了。
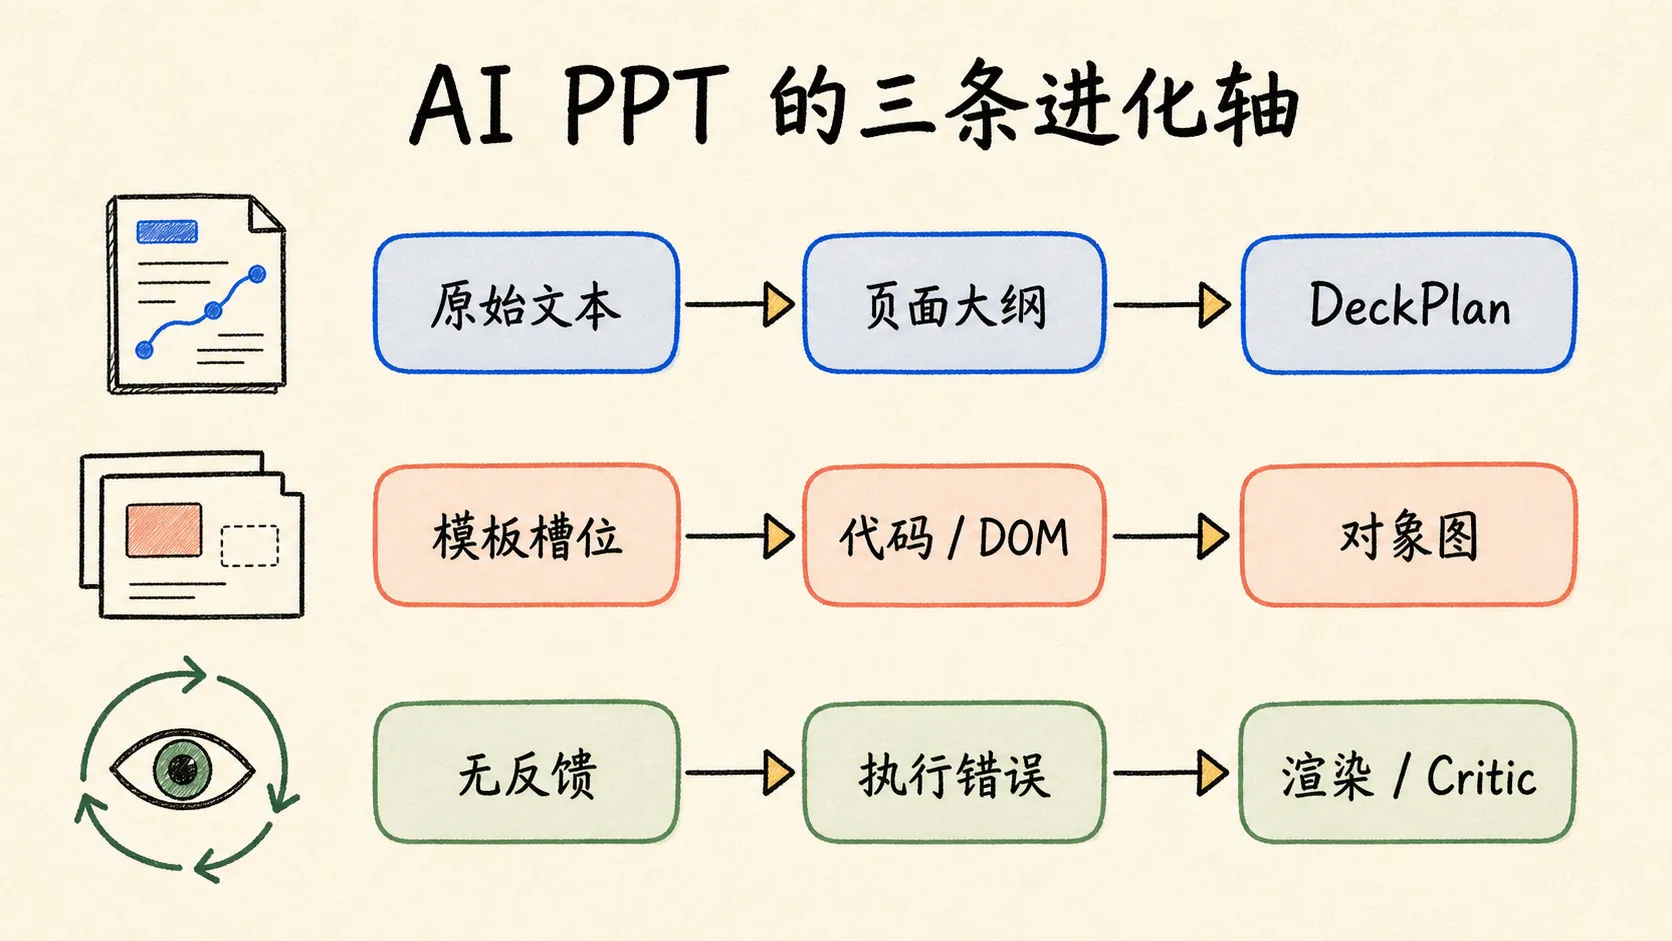
叙事、页面表示和反馈机制同时在变,旧办法也一直留在新系统里。
模板先替软件缩小了问题
生成式 AI 出现以前,演示工具已经在自动排版。
Beautiful.ai 对 Design AI 的说法很直接。它把间距、对齐和层级写成规则与启发式约束,再让系统按内容变化调整页面。Smart Slides 继续沿用这套思路。用户选时间线、对比页或图片墙,软件负责重排和缩放。
这里没有一个模型站在空白画布前猜每个坐标。页面类型先把选择范围压小了。规则牺牲一些自由,也换来稳定结果。直到今天,很多 AI PPT 产品仍然靠这一层兜底。
同一时期的学术工作更愿意从数据里学习文档到演示文稿的转换。DOC2PPT 同时处理摘要、图片检索、文字改写和布局预测。它留下的经验和规则引擎很接近。模型要碰页面,页面得先变成它能操作的结构。
Gamma 先解决了空白页
第一波生成式 AI PPT 最有用的地方,是让人不用从第一页空白画布开始。
Gamma 很典型。它在 2022 年就把基本单位做成了 Card。Card 高度可以变化,里面能放文字、图片、视频和网页嵌入,也能随屏幕重排。联合创始人 Grant Lee 在访谈里说,这套原语原本服务于异步沟通和响应式阅读,出现时间早于产品接入大模型。
这套结构后来很适合生成。模型决定一段内容讲什么,适合时间线还是双栏,Card 系统处理页面流动,不用让模型直接求解任意二维坐标。
Gamma 在 2023 年公开过更早期的 AI 架构。系统调用 OpenAI API,先判断用户意图,再路由到不同 Prompt,文字和图片生成也分开处理。团队用 few-shot 示例和内部 Prompt Studio 调试结果。Jon Noronha 在访谈里复盘得很坦白,AI 的直接价值是跨过空白页,一次给出提纲、正文、模板和配图,用户再回编辑界面继续收拾。
这条管线现在仍很常见。
主题或原始文档
  → 大纲
  → 页面拆分
  → 布局选择
  → 文字与图片
  → 模板或组件
它把第一步做得很快。用户开始改内容时,难处又回来了。一个结论变长,图片可能需要换,原来的双栏也装不下。系统只会整页重生,已经满意的部分很难留下。AI PPT 接下来几年的工程,很多都在解决这个局部修改问题。
代码让模型碰到了页面对象
python-pptx 和 PptxGenJS 早就能创建 PowerPoint 文件。大模型普及以后,代码成了自然语言通往这些库的适配层。模型写程序,运行时执行,最后得到文字、图片、形状和图表组成的对象图。
AutoPresent 在 SlidesBench 的单页任务中比较过端到端图像生成和程序生成。后者在这组实验里做出了质量更高、可以继续交互的结果。论文还单独用 GPT-4o 读取上一版代码和渲染截图,再迭代修改。这个实验不能算作 AutoPresent 的 8B 模型已经会自主修复,两项能力需要分开看。
代码把页面变成可执行规格,也带来了新的麻烦。程序会报错,坐标会越界,换一台机器可能找不到字体。开放式 Python 和 JavaScript 还能访问文件与网络。产品若要提供这条路,就得准备隔离执行环境、资源限制和可以审计的工具边界。
HTML/CSS 也很受欢迎。浏览器懂排版,模型又熟悉前端代码,用它做出丰富页面通常更容易。问题出在交付。DOM 里的响应式布局、滤镜和网页字体,很难一项不漏地翻译成 PowerPoint 对象。
Marp CLI 展示了这笔取舍。普通 PPTX 导出主要使用预渲染背景图,页面内容不能继续编辑。实验性的 --pptx-editable 依赖浏览器和 LibreOffice,官方也提醒复杂样式可能丢失,视觉复现会变差。
交付质量最后落在一个很具体的选择上。页面进入 PPTX 时,可以是一张位图,也可以是一组带语义的原生对象。文件扩展名看不出这道差别。
图片开始参与理解页面
图片最早只是内容槽位里的素材。系统按主题搜图库,或者调用文生图模型做一张插画。后来,一些产品干脆把整页做成图片,绕开了对象布局。视觉自由了,编辑能力也一起消失。
再往后,渲染图有了另一份工作。它把用户实际看到的页面送回系统,帮助系统理解对象列表里没有写明的关系。
Canva 的工程文章 How we see groups in design 给了一个很具体的例子。一张表格可能是原生表格,也可能由文字、直线和矩形拼出来。元素列表只记录这些零件,没记录它们共同组成一张表。Canva 同时使用页面栅格图和元素信息,视觉模型先找出表格、图表和示意图等隐式分组,再把检测框映射回已有的可编辑元素。
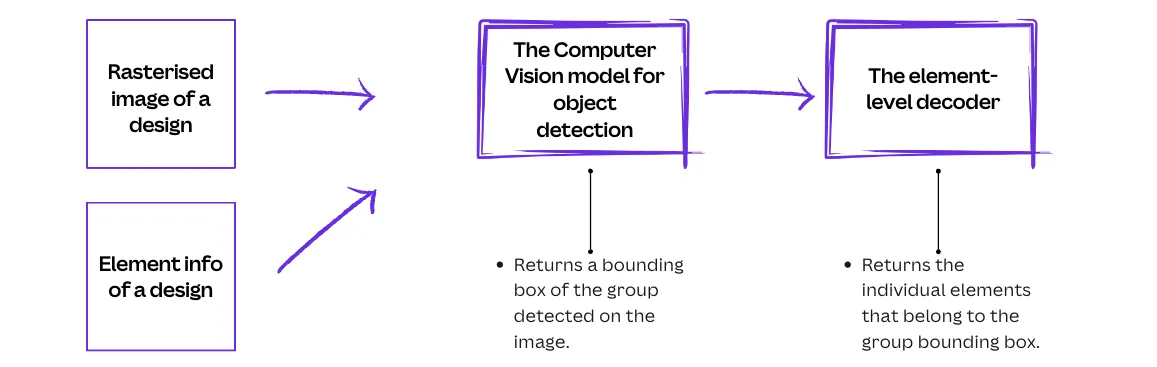
图来自 Canva 的分组识别工程文章。
对象图告诉系统页面里有什么,像素告诉它这些东西摆在一起以后长什么样。两种视图放在一起,系统才有机会同时理解结构和观感。
模板开始记住一套设计怎样工作
模板也变了。早期模板给背景、字体和几个占位框。新的系统会从参考页里归纳页面功能、内容密度和对象关系,再决定该借哪一页来改。
PPTAgent 走的是参考稿编辑路线。它先分析一份已有演示文稿,按页面功能、布局和视觉特征做归纳,再提取内容 Schema。生成新 deck 时,系统先写大纲,为每页挑参考布局,随后修改原有对象。
实验代码把可用操作收得很窄。模型调用 clone、delete、replace 等注册动作,没有任意执行整段 Python。设计空间变小以后,执行错误更容易发现,重试也更有边界。
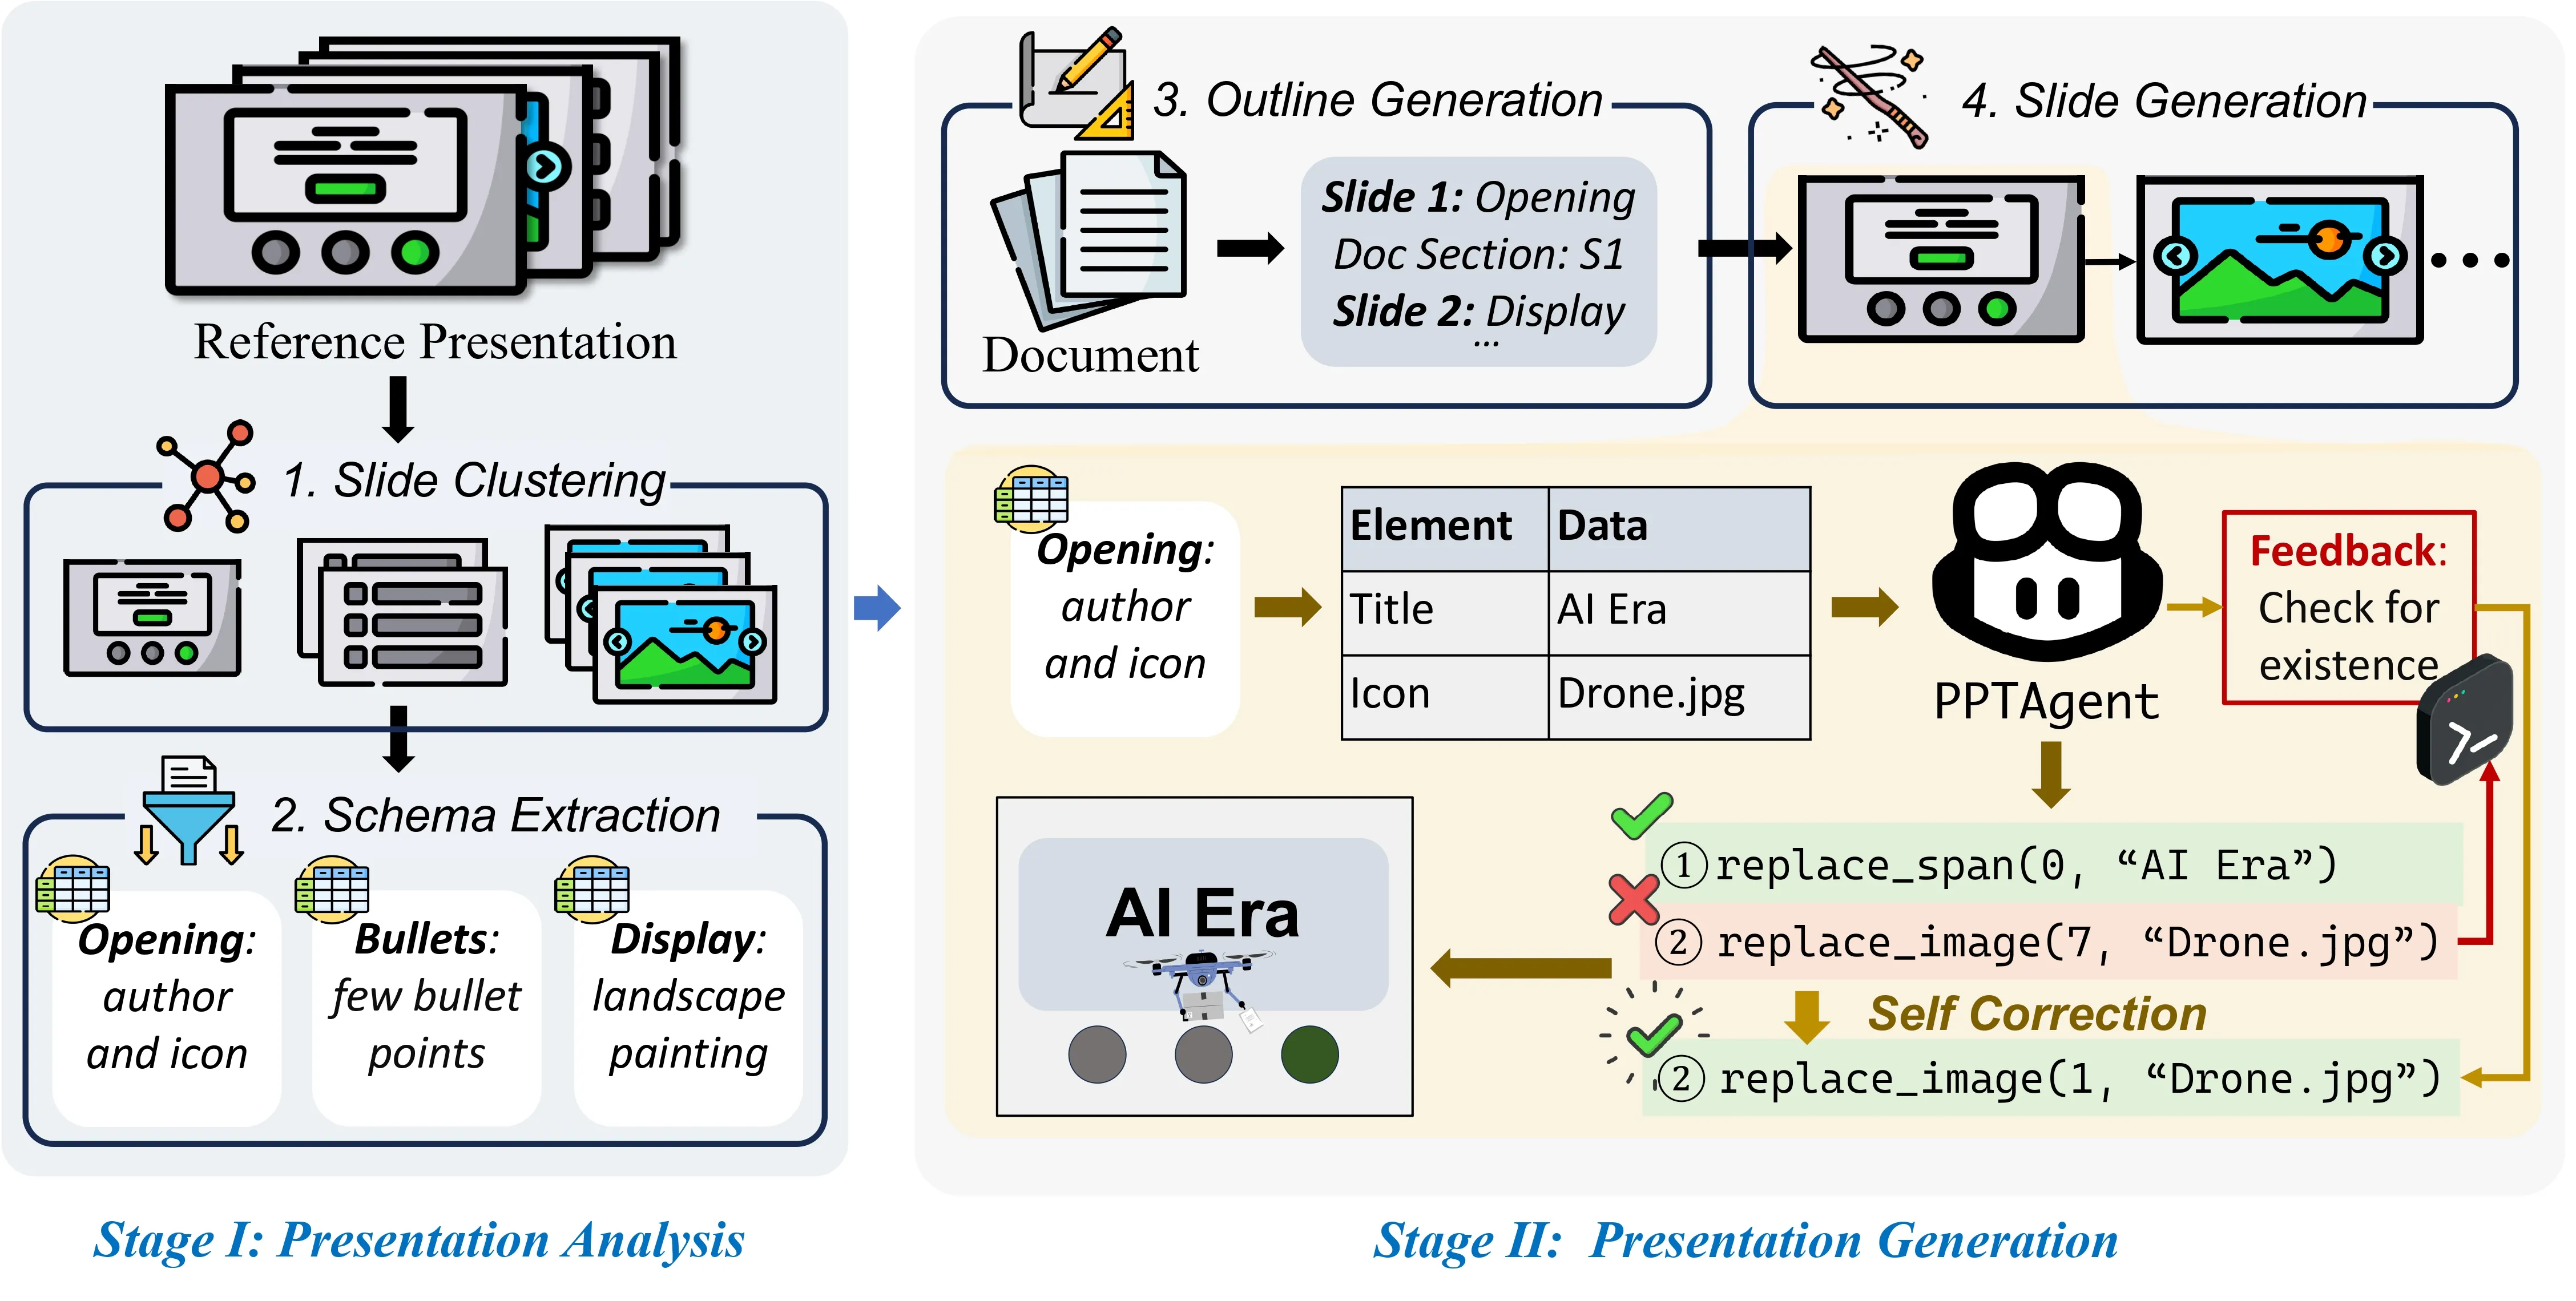
图来自 PPTAgent 公开仓库。

商业产品公开的行为也能看到这条变化。微软的 PowerPoint Copilot 模板说明提到,Copilot 主要读取样例页,其次读取母版和布局。它会参考占位符类型、内容密度和视觉层级。文档没有说企业模板会拿去训练模型权重,这个边界要留着。
Pitch Agent 公开提到的内容更细,除了字体和颜色,它还会读取间距、区块结构、装饰元素和图片风格。厂商没有公开内部打分算法,我们能确认的是产品行为。模板正在从静态皮肤变成一套可以执行的设计规则。
有了页面语义和有限动作,Agent 才能稳定地改当前选区或一页里的某个组件。它可以拆页、换图、改写一段文字,也能保留用户已经调好的其他部分。
系统学会回头看成品
程序跑通,PPTX 能打开,页面仍然可能坏掉。标题溢出,正文压住图片,字体替换以后多换一行,这些错误通常不会让代码报异常。
DeepPresenter 把渲染后的 HTML 页面重新送回模型。模型看到环境里的真实结果,再继续修改。这种 environment-grounded reflection 比检查代码文本多了一层依据,至少能发现浏览器已经画出来的遮挡和失衡。
论文里的反馈对象是 HTML 页面。它没有证明转成 PPTX 以后仍然一致。项目主分支后来加入的实验性 HTML 转换器提供了另一份工程线索。浏览器先计算 DOM 边界、样式和实际字体,转换器把常见文字、图片、形状、列表和表格映射为 PptxGenJS 对象。复杂渐变和阴影找不到稳定映射时,就降级成图片。
这类系统通常同时做几种检查。Schema 和执行器看代码有没有跑通,几何规则找溢出与重叠,视觉模型判断层级和观感。它们处理的错误不同,少一层都可能留下盲区。
EvoPresent 专门研究审美反馈如何帮助 Agent 自我改进。它的实验显示,高质量反馈会让改进更快,也更容易达到较好的结果。初始能力强的模型并不会自然获得有效纠错能力。这个结论来自它的 HTML 演示生成任务,适用范围不能随手扩大。
一页漂亮还不够
早期系统常把长文压成若干要点,再逐页生成。这样能得到一组主题相关的页面,整场演讲的论证却可能断掉。前一页刚抛出问题,后一页已经换了话题;结论在三页里反复出现,关键证据反而没位置。
ArcDeck 把论文转幻灯片当作叙事重建。它先解析原文的 discourse tree,再建立一份全局 commitment document,让不同 Agent 围绕同一份承诺批评和修改大纲,之后才进入布局与渲染。
这件事把中间表示往上提了一层。页面级的 SlideSpec 记录这一页的目的、证据和视觉意图,DeckPlan 记录整套演示要完成的论证。它们还不能直接画出一页 PPT,需要继续交给模板、HTML 或对象图执行。
资料、受众和品牌
  → DeckPlan
  → SlideSpec
  → 模板选择、参考页编辑或代码生成
  → DOM、Scene Graph 或 PowerPoint 对象图
  → 实际渲染
  → 几何检查、视觉 Critic 和叙事 Critic
  → 定点修改
  → PPTX、Web 或 PDF
这条链里没有一个万能格式。HTML 适合预览和计算几何,PowerPoint 对象适合交付后继续编辑,位图适合承载很难稳定结构化的视觉效果。成熟系统得知道每一层保存了什么,转换时又丢了什么。
模型之外的东西决定了上限
看完这些项目,我更在意系统能不能把中间状态留下来。DeckPlan 和 SlideSpec 一旦消失,用户改一句话,模型又得从头猜整套意图。它们保存下来,局部修改才有依据。
布局执行器也很要紧。模型可以挑结构、写内容、提出修改,稳定的对齐、换行和字体回退仍要交给确定性代码。页面对象还得知道哪些文字和线条属于同一张表,哪些形状组成一个图示,否则 Agent 每次都在操作一堆孤立坐标。
渲染以后再检查,把浏览器、LibreOffice、PowerPoint 和不同字体环境造成的偏差暴露出来。企业产品还要接入文档权限、品牌资产和历史演示。通用模型会越来越普及,这些上下文和编辑运行时更难照搬。
AI PPT 走到这里,已经很像一个小型设计系统。规划器管叙事,执行器管页面,Critic 盯着成品,用户在中间随时插手。模型写文案仍然有用,只是它在整条链里占的位置没有宣传页看起来那么大。
我们为什么做 Skena
这也是我们做 Skena 的缘由。Skena 目前是一套声明式 TypeScript 演示文稿框架,先把页面编译和双后端输出做稳。它的主线很短。
TSX
  → Scene Graph
  → 确定性布局与文字测量
  → Prepared Scene
  → SVG 预览和原生可编辑 PPTX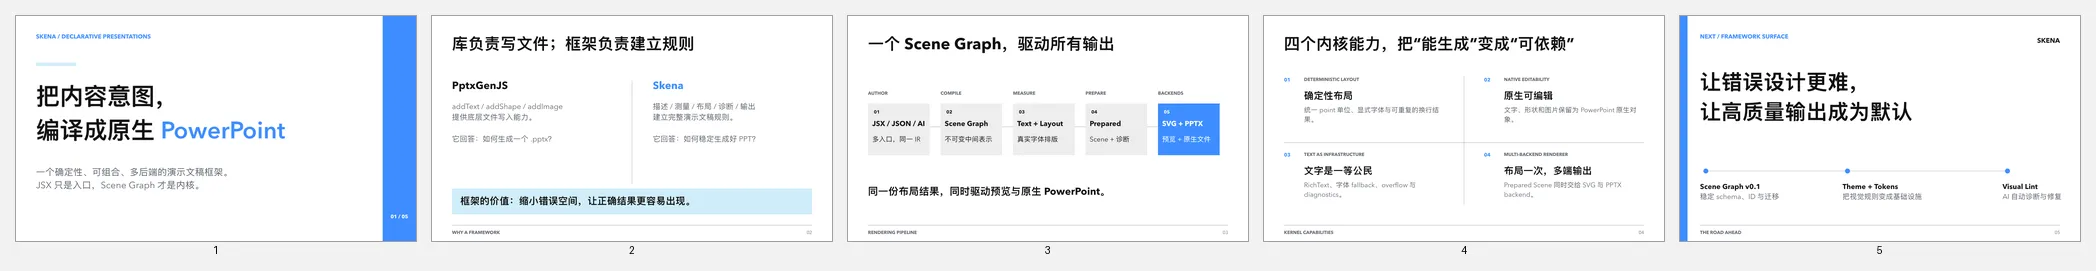
这是 Skena 本地示例生成的五页 contact sheet。
同一份 Prepared Scene 同时交给 SVG 和 PPTX 后端。普通文字与形状尽量保留成 PowerPoint 原生对象。标题若对视觉一致性要求更高,也可以显式选择轮廓化,并接受文字不能继续编辑的代价。
Skena 还在 pre-alpha。它没有内置 LLM、Agent 规划、参考模板学习和视觉 Critic,API 与 Scene Graph 也会继续变。我们眼下先做一件基础工作。给模型一门受约束的设计语言,同时保住确定性预览和 PowerPoint 里的编辑空间。